C++ STL [List & Forward_List]
List
→ 정의 : ‘이중 연결 리스트’ 자료구조를 기반으로 한 Node 시퀀스 컨테이너로, 원소를 노드 단위로 저장한다. 하나의 노드가 다음 노드, 이전 노드를 가리키는 포인터 변수를 가지고 있다.
→ 특성 : 동적으로 데이터를 저장할 수 있고, 데이터가 연속적으로 저장된다. 위치만 알고 있으면, 추가/삽입/삭제가 O(1) 시간 복잡도로 빠르게 수행이 가능하다.
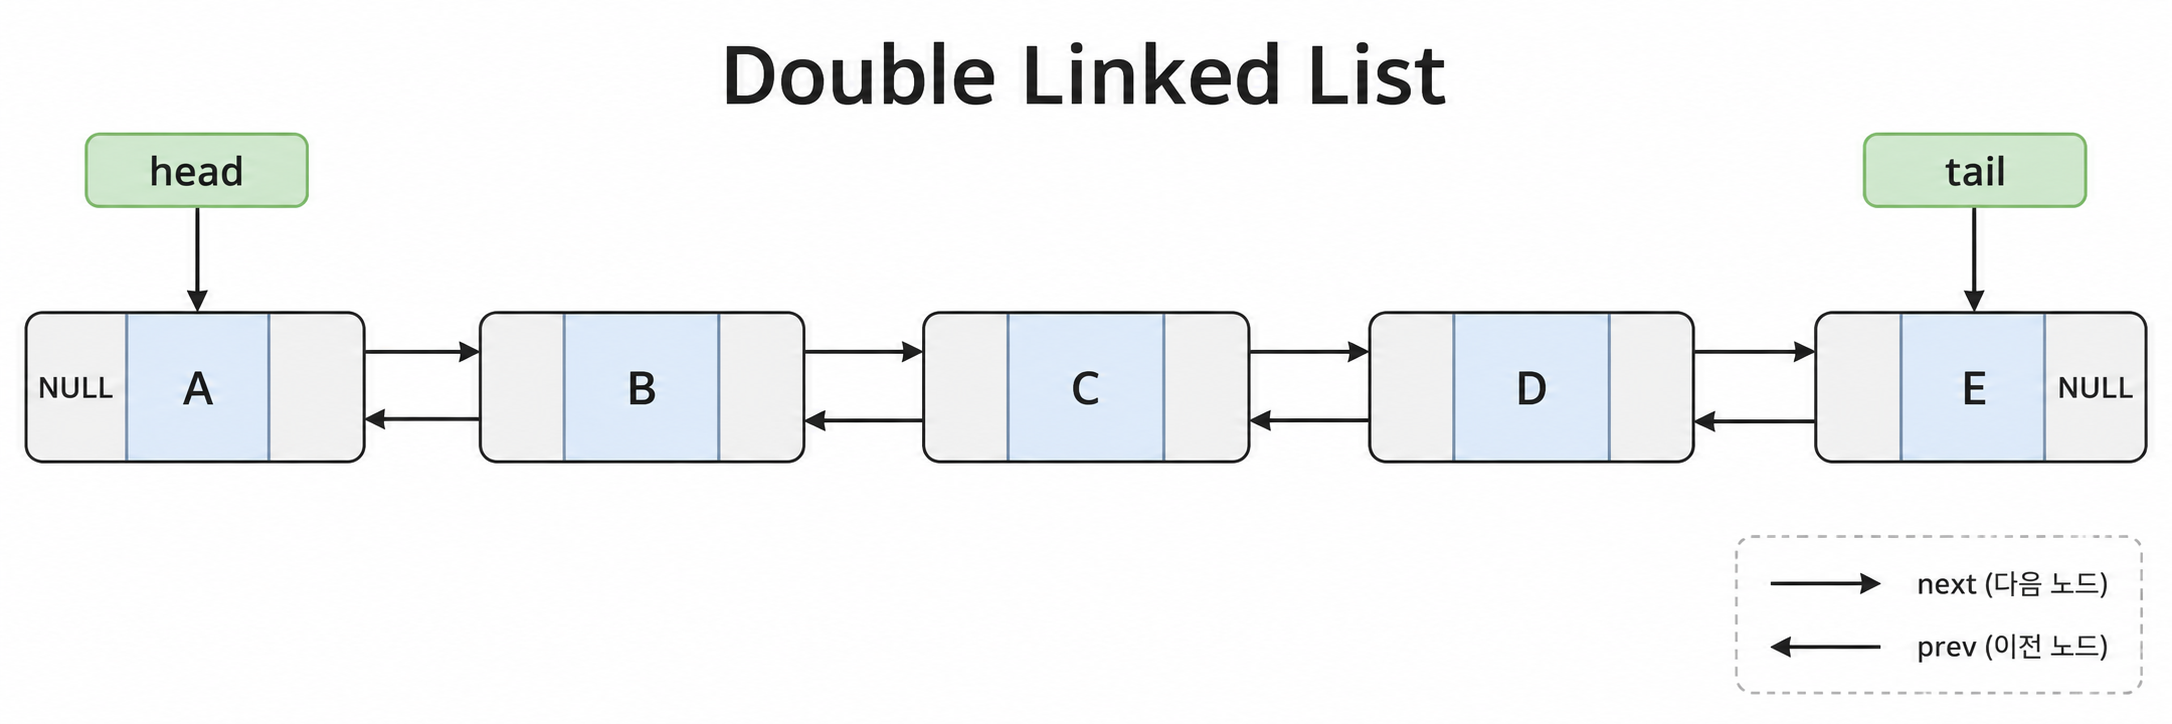
→ 동작 : 노드 전체를 관리하는 리스트 클래스와, 노드 자체가 정의되어 있다. 노드 전체를 관리하는 컨테이너는 [첫 노드의 포인터], [마지막 노드의 포인터]와 원소의 총 갯수를 나타내는size_t자료형의 size변수가 정의되어 있다. 노드 자체는 [데이터], [다음 노드 포인터], [이전 노드 포인터] 이렇게 3개의 멤버 변수를 가지고 있다. 이 노드와 list 클래스를 사용해서 각 함수를 동작 시킨다.
※ 아래 코드는 std::list의 동작을 이해하기 위한 개념적인 단순화 구조이며, 실제 STL 구현은 다를 수 있다.
template <typename T>
struct Node {
	T data; // 실제 데이터
	Node* prev; // 이전 노드 포인터
	Node* next; // 다음 노드 포인터
};

template <typename T>
class list {
private:
	Node<T>* head; // 첫 노드의 포인터
	Node<T>* tail; // 마지막 노드의 포인터
	size_t size_;  // 전체 요소 개수

public:
	// Method
};
→ 강점 :
- 삽입(추가)/삭제가 빠르다 - 중간 삽입/삭제여도 위치만 알고 있다면, 양 옆 노드의 포인터만 변경해주고, 삽입되는 노드의 포인터도 양 옆을 지정해주면 된다. 데이터양 무관하게 항상 같은 로직으로 수행되므로, O(1) 시간 복잡도로 수행된다.
- 재할당이 없음 - 리스트는 필요한 메모리 노드 1개만 받아오고, 반환하면 되므로 재할당을 할 필요가 없다. 그렇기에 이에 대한 오버헤드에 고민할 필요가 없다.
→ 단점 :
- 낮은 캐시 히트율 - 보통 데이터를 가져올 때, 캐싱을 위해 연속적인 메모리의 Cache Line을 가져와 빠르게 데이터에 접근한다. 이걸 캐시히트라고 하는데, 데이터가 불연속적으로 저장되고 널리 퍼져있어, Cache Line에 다음 데이터가 없을 확률이 높아, ‘캐시 히트’의 혜택을 보기 힘들다.
- 노드의 메모리 오버헤드 - 데이터 하나를 저장하는데, 데이터 뿐만 아니라 두 개의 포인터까지 같이 저장하게 된다. 노드 하나당 { 16Byte + DataSize } 이므로, 대량의 메모리 저장에는 비효율적인 자료구조가 된다.
- 느린 접근 - 변수에 저장해두지 않는 이상, list의 처음부터 끝까지 순회를 하면서 데이터를 찾아야 한다. 데이터가 늘어날 수록 순회해야 할 데이터가 더 많아져, O(N) 시간 복잡도를 가지게 된다.
Method
※ 원소 접근자
| 함수 | 반환 | 설명 | 시간 복잡도 |
|---|---|---|---|
| front() | ref | 첫 번째 원소에 접근 | O(1) |
| back() | ref | 마지막 원소에 접근 | O(1) |
※ 반복자
| 함수 | 반환 | 설명 |
|---|---|---|
| begin() / cbegin() | iterator / const_iterator | 첫 번째 원소를 가리키는 iterator |
| end() / cend() | iterator / const_iterator | 마지막 원소의 다음 위치를 가리키는 iterator |
| rbegin() / crbegin() | reverse_iterator / const_reverse_iterator | 역순 순회의 첫 번째 원소를 가리키는 reverse iterator |
| rend() / crend() | reverse_iterator / const_reverse_iterator | 역순 순회의 마지막 다음 위치를 나타내는 reverse iterator |
※ 용량 확인
| 함수 | 반환 | 설명 | 시간 |
|---|---|---|---|
| empty() | bool | List가 비어있는지 확인 | O(1) |
| size() | size_type | 현재 저장된 원소의 개수를 반환 | O(1) |
| max_size() | size_type | List가 이론적으로 저장할 수 있는 최대 원소의 개수를 반환 | O(1) |
※ 수정자
| 함수 | 반환 | 설명 | 시간 복잡도 |
|---|---|---|---|
| clear() | 모든 원소를 제거 | O(N) | |
| insert(pos, value) | iterator | pos 가 가리키는 위치의 앞에 원소를 삽입 | O(1) |
| emplace(pos, args...) | iterator | pos 앞에 새로운 원소를 직접 생성하여 삽입 | O(1) |
| push_front(value) | List의 맨 앞에 원소를 삽입 | O(1) | |
| push_back(value) | List의 맨 뒤에 원소를 삽입 | O(1) | |
| emplace_front(args...) | ref (since C++17) | List의 맨 앞에 원소를 직접 생성 | O(1) |
| emplace_back(args...) | ref (since C++17) | List의 맨 뒤에 원소를 직접 생성 | O(1) |
| pop_front() | 첫 번째 원소를 제거 | O(1) | |
| pop_back() | 마지막 원소를 제거 | O(1) | |
| erase(pos) | iterator | pos가 가리키는 원소를 제거 | O(1) |
| erase(first, last) | iterator | [first, last) 범위의 원소를 제거 | O(N) |
| resize(count) | 원소의 개수가 count가 되도록 List의 크기를 변경 | 변경되는 원소 수에 비례 | |
| swap(other) | 다른 List와 내용을 교환 | O(1) |
※ List 특화 연산
| 함수 | 반환 | 설명 | 시간 복잡도 | 특징 |
|---|---|---|---|---|
| splice(const_iterator pos, list& other) | 다른 List의 노드를 현재 List의 특정 위치로 이동 | O(1) / 범위 이동 시 O(N) | 원소를 복사하지 않고 노드의 연결 관계를 변경 | |
| merge(list& other) | 정렬된 두 List를 하나의 정렬된 List로 병합 | O(N + M) | 두 List가 같은 기준으로 정렬되어 있어야 함 | |
| remove(value) | size_type (since C++20) | 지정한 값과 같은 모든 원소를 제거 | O(N) | 전체 원소를 순회하며 값을 비교 |
| remove_if(pred) | size_type (since C++20) | 조건을 만족하는 모든 원소를 제거 | O(N) | 각 원소에 Predicate를 적용 |
| unique() | size_type (since C++20) | 연속해서 중복된 원소를 제거 | O(N) | 인접한 중복 원소만 제거 |
| sort() | List의 원소를 정렬 | O(N log N) | List 자체의 정렬 함수 사용 | |
| reverse() | List의 원소 순서를 역전 | O(N) | 노드의 연결 순서를 반대로 변경 |
→ splice() 부연 설명
splice는 한 list의 노드들을 다른 위치로 직접 옮기는 함수로, ‘복사’ 방식이 아닌 ‘노드의 관계를 변경‘하기 때문에, 데이터 양 관계 없이 같은 연산을 한다. 그러므로 O(1)의 시간 복잡도. 결과로는 splice 두 번째 매개변수에 들어가는 list는 비워져, empty 상태가 되고, 원본 list는 원소가 추가된다. 다음과 같이 사용한다.
std::list<int> listA = { 1, 2, 3 };
std::list<int> listB = { 10, 20 };

auto pos = std::next(listA.begin());

listA.splice(pos, listB);
// Result :
// listA : 1 10 20 2 3
// listB : empty
Forward_List
→ 개요 : C++11에서 새롭게 forward_list가 추가되었다. ‘단방향 리스트’를 기반으로 한 리스트로, list 클래스에는 [첫 노드의 포인터]만 남겼고, 노드에는 [데이터], [다음 노드의 포인터] 로 메모리를 절약했다. 이를 통해서, 메모리 오버헤드를 감소시켜 기존 list의 문제를 개선하였지만, 여전히 노드가 포인터를 가지고 있다는 점에서 단점이 완전히 해결된 것은 아니다.
→ 새로 추가된 문제 : 양방향 list에서는 임의의 노드에서 다음 노드, 이전 노드로 이동이 가능했다. 하지만, 단방향 리스트는 다음 노드로만 이동이 가능하기에, 동시에 역방향 순회도 불가능해진다.(사실 많이 필요한가 싶다.) 또한, 경량화를 위해서 size() 함수를 없앴기에, 원소 갯수를 세려면 순회를 해야 알 수 있다(O(N) 시간 복잡도).
※ Forward List 전용 연산
| 함수 | 반환 | 설명 | 시간 복잡도 |
|---|---|---|---|
| before_begin() | iterator | forward_list의 시작 원소의 이전 iterator를 반환. (역참조 불가) | O(1) |
| insert_after(pos, value) | iterator | pos 가 가리키는 위치의 뒤에 원소를 삽입 | O(1) |
| erase_after(const_iterator pos) | iterator | pos 뒤 원소를 제거 | O(1) |
| splice_after(pos, forward_list& other) | pos 뒤에 두 번째 매개변수 list를 splice 함. (매개변수도 forward_list여야 함.) | O(N) |
iterator 유효성
→ vector에서는 재할당 또는 일부 삽입/삭제 과정에서 미리 변수로 받아 놓은 iterator가 ‘무효화‘될 위험이 있다. 재할당은 새로운 메모리 공간을 만들고 원본에서 새로운 공간으로 복사시키는 과정이기 때문에, 기존 iterator가 기존 원소를 가리킨다는 보장이 없다. 하지만 list는 이 과정이 없고 기존 노드가 이동할 일이 없다. 그렇기에 iterator가 원소를 한 번 가리키면, 해당 원소가 삭제되지 않는 이상 계속 유지될 수 있다. list는 iterator가 다른 연산에 의해 무효화되지 않는 특성이 있다.(forward_list도 포함)
vector 와 list
→ 실무 사용 : list는 중간 삽입/삭제가 O(1)로 빠르게 수행할 수 있지만, vector는 뒤에 있는 원소들을 이동시키는 비용 때문에 O(N)이다. 자료구조 이론 상으로는 맞지만, 실제 C++ 프로그램에서 시간 복잡도만으로 성능을 판단하긴 어렵다.
vector는 연속된 메모리 구조이기에 다음 원소로 이동할 때 Cache의 도움을 받을 수 있는데, Cache Line에 해당 원소가 있다면 빠르게 접근이 가능하다. 반면에 list는 메모리 위치가 제각각이기에, 다음 원소로 이동하게 되면 Cache의 도움을 받을 확률이 상대적으로 적다. 결국 더 하위의 Cache나 Main Memory까지 내려가 메모리를 가져오게 되고, 비용이 증가하기에, 경우에 따라 vector의 O(N) 연산이 list의 노드 기반 연산보다 빠른 경우도 있다.
또, list의 삽입/삭제는 O(1)이지만, “위치를 알고 있는 경우”에 한한다. 위치를 알지 못하고, 값만 알고 있는 경우에는 순회 후, 제거이므로 순회 비용인 O(N)의 성능을 보이게 된다. 또한 list의 메모리 오버헤드는 list가 대용량 메모리들을 관리하기에 비효율적인 이유기도 하다.
list에서 중간 삽입/삭제, 두 컨테이너 병합, iterator 유지가 vector를 이기는 이유기도 하지만, 데이터 저장과 순회가 STL을 사용하는 목적이라면, vector가 일반적으로 더 효율적이고, 삽입/삭제만 바라보기에는 map/unordered_map에서도 충분히 효율적으로 가능하고, 다른 기능에서도 활용도가 높다.
결국에 list는 정말 한정적인 상황에서만 빛을 본다고 할 수 있다. Node(데이터)들 간에 순서가 필요하고, 이를 재배치(splice)하는 경우가 빈번할 때가 list가 다른 STL들 보다 가장 좋은 경우이다.
Comments